架构:一个云函数撑住九个应用
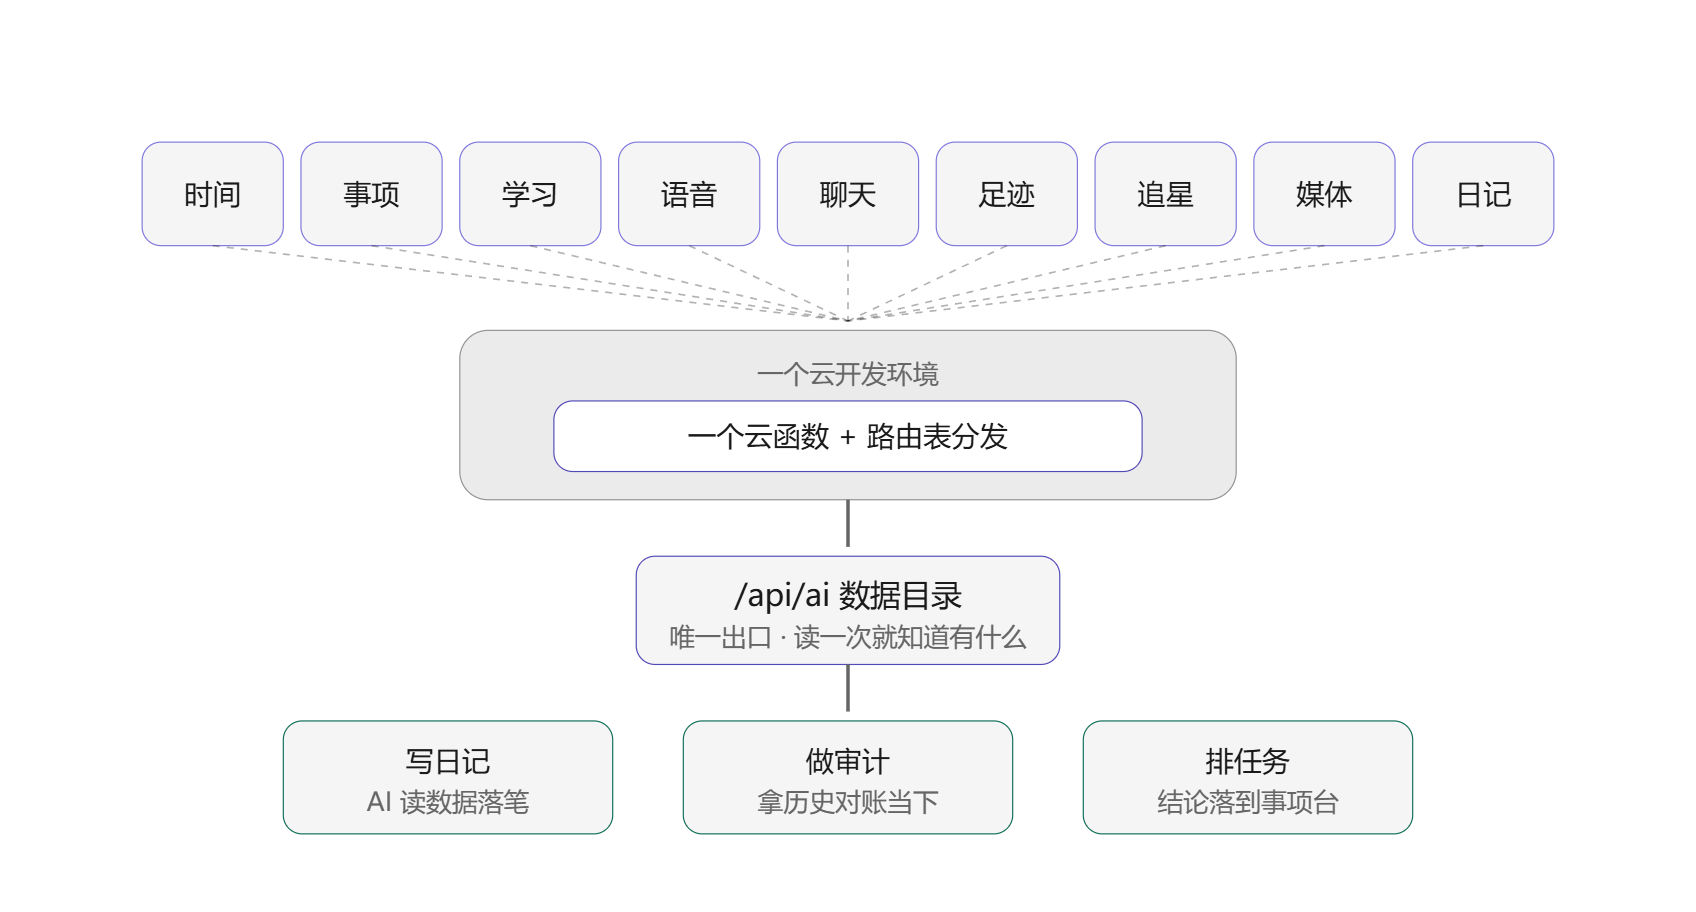
所有数据都在同一个云开发环境里,由一个云函数使用一张路由表分发各自应用的业务。 在个人使用的低并发场景下,一个云函数带多个应用完全够用 —— 不必为每个应用单独养一套后端。
九类应用各自采集
时间、事项、学习、语音、聊天、足迹、追星、媒体、日记。每个入口只管把数据写好。
一个云函数 + 路由表
少并发下,一个云函数分发多个应用的业务,省掉为每个应用单独养一套后端。
/api/ai 数据目录
所有数据经这一条路由暴露。新增数据源只需在路由下挂一个路径,AI 读一次就知道有什么、怎么调。
写日记 · 做审计 · 排任务
日记 AI 读数据写记录,工作 AI 据讨论把计划和执行细节直接落到事项台。
博客数据、资源下载等也在这个云开发环境里,但它们偏工具层,属于办公便携数据,不算进个人管理这九类。
组成:九类数据源
十来年攒下的记录,如今汇到同一个环境。每一类都有独立的采集入口,也都挂在同一条 AI 路由下。
时间日志
DayLedger2023 年起 · 821 天
一天 1440 分钟按分钟记,没记的部分显式留白。另有独立作品页与开源源码。
事项台
事项2026 年 10 月自建
收集箱 / 工作 / 生活 / 学习四个清单,四象限、重复任务、子任务。也是 AI 结论的落点。
学习台
FSRS2026 年 10 月自建
间隔重复刷题,FSRS 调度。增长最快的数据源。
语音记录
转写2026 年 11 月自建
手机被动监听,只录有人说话的片段,端上转成文字。客户端精度调试中。
聊天记录
转发2026 年 11 月自建
从微信合并转发给机器人再落库的片段。只提供只读检索接口。
足迹地图
地图2026 年 7 月自建
去过的、想去的点,带 Markdown 路书。另有独立作品页与开源源码。
追星档案
人物2026 年 8 月自建
公众人物资料,追星用。
媒体库
书影音2017 年起积累
各处攒下来的书、影视、小说等条目。
白守日记
日记2013 年起积累
日记与人物档案。既是数据源,也是这套机制里写日记、做审计的那个 AI。
四个应用,各管一摊
九类数据不是塞进一个 App,而是各环节用最合适的工具采集,再把数据汇到同一处。 其中四个应用的前端与云函数后端会作为一个仓库放出:
事项台
四清单 + 四象限 + 重复任务 + 子任务。既喂数据,也是 AI 把决策落成行动的出口 —— 闭环在这里合上。
学习台
FSRS 间隔重复刷题。复习记录进中枢后,AI 能分辨「没时间学」和「在快速划过去假装学」。
媒体库
书、影视、小说的收集与检索。2017 年起的条目汇入后,成为「读过 / 看过」那部分的事实底账。
微信聊天转发
合并转发给机器人后落库,提供按关键词/会话的只读检索接口。采集端不开源,任何真实对话都不入库仓库。
用起来是什么样
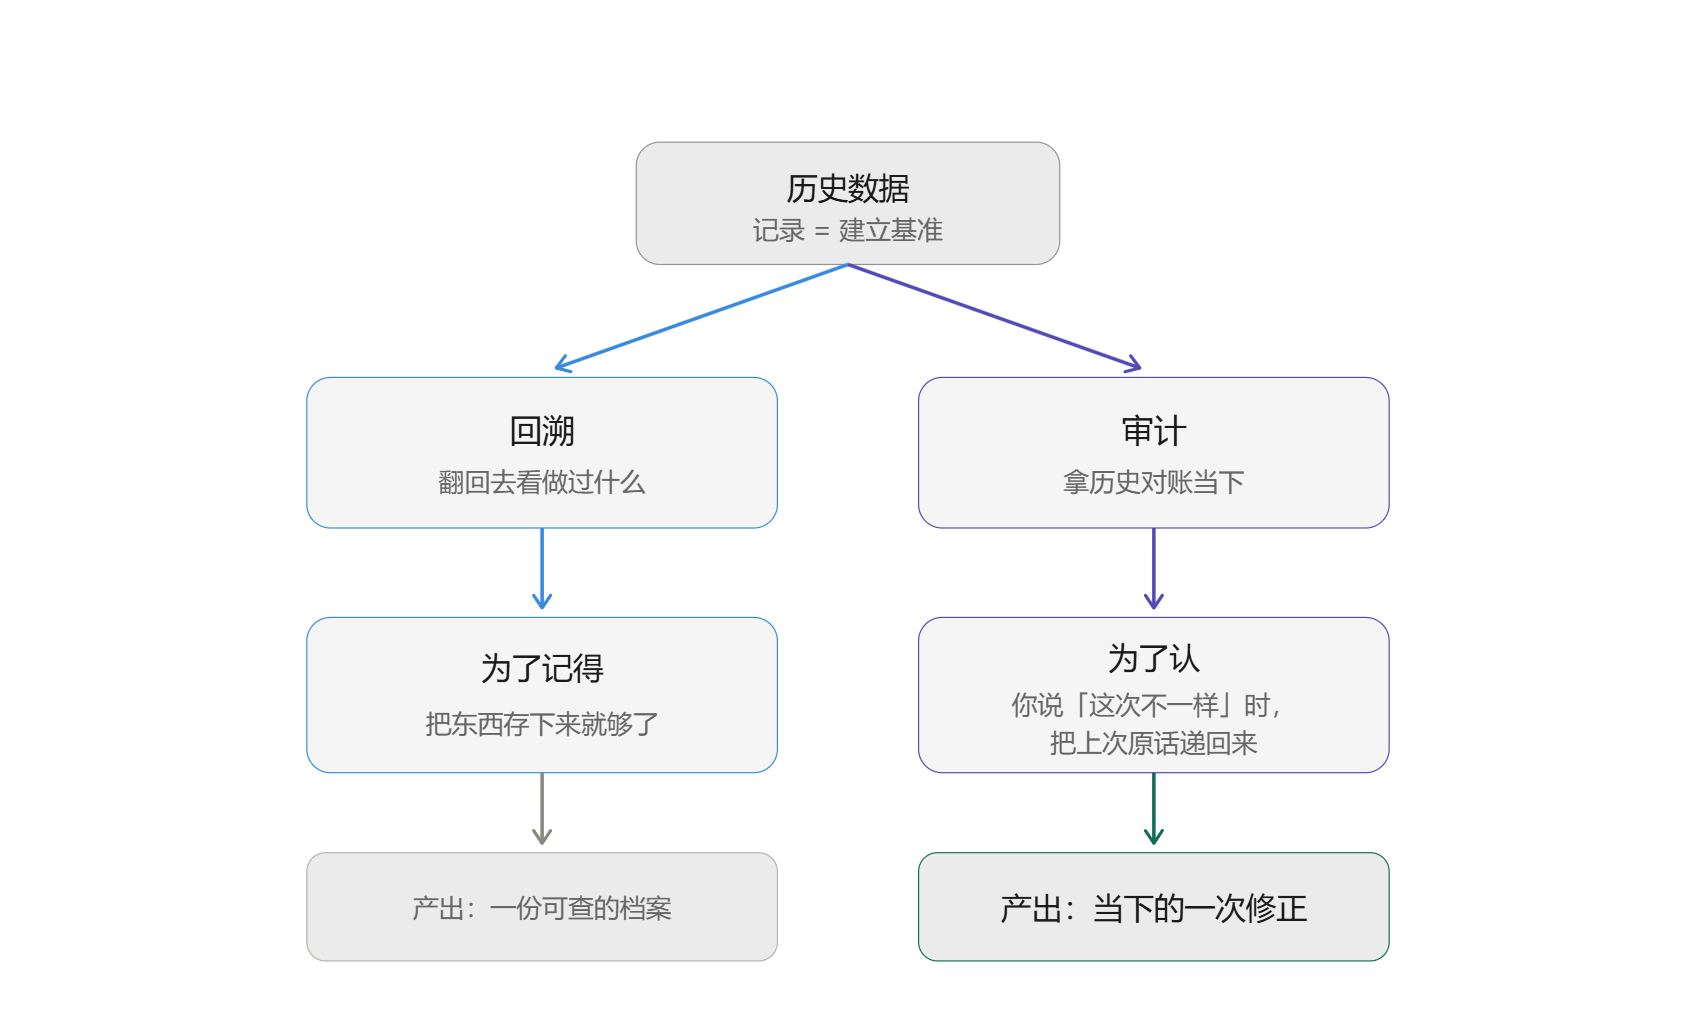
把数据交给 AI 之后,它能做的不是「统计」,而是拿你自己的历史去审视当下。 下面几件事按给人的阻力从小到大排 ——
拿数据对账
场景周任务连续逾期。
AI 动作拉出 14 天时间日志:刷题 14 小时 41 分,比上一周期还多一分钟。
结果「你不是没学,是没在学周任务」,并给出改成按天或按题量的建议。
拆「我在努力」
场景复习记录看起来很勤。
AI 动作翻出大量 0.4~1.0 秒就点「没记住」的条目。
结果指出这是快速划过去的注水 —— 自我感动比拖延更难拆。
翻旧账,不接借口
场景给当下状态找了个解释。
AI 动作去历史记录里找到同类说法,看这个解释是怎么搭起来的。
结果分清哪些是真实想法、哪些是懒惰的借口。
它守的是底线
场景嘴上说没事,作息却在乱。
AI 动作把作息与状态记录交叉比对。
结果留下一句「身体的应激比脑子诚实,压力在找出口」。
已知边界
-
语音链路精度还很差
这条链路最近半个月才打通,声纹识别、录音转写一堆问题,一天里常有两三百句需要校准。客户端调好精度后才会单独开源。
-
记录不到沉默
能记下打出的字、说出的话,记不下沉默时在做什么。有些重的事发生在不对任何人说的时候 —— 只能靠想起来补给它。
-
只能看见有格子装的东西
分类表决定了 AI 能看见什么,而分类表是自己画的。没有对应的格子,那段数据在系统里就是隐形的。
-
它可能把我钉在原地
镜子里的我是过去的我。机制越结实,越容易被旧结论锁住 —— 拿着旧标签持续定义当下,是这套系统最隐蔽的风险。